萌系大模型训练图解
A friendly educational infographic uses original mascots and a playful pipeline to explain data preparation, tokenization, pretraining, feedback tuning and generation without relying on real logos.
gpt-image-2.5 图像
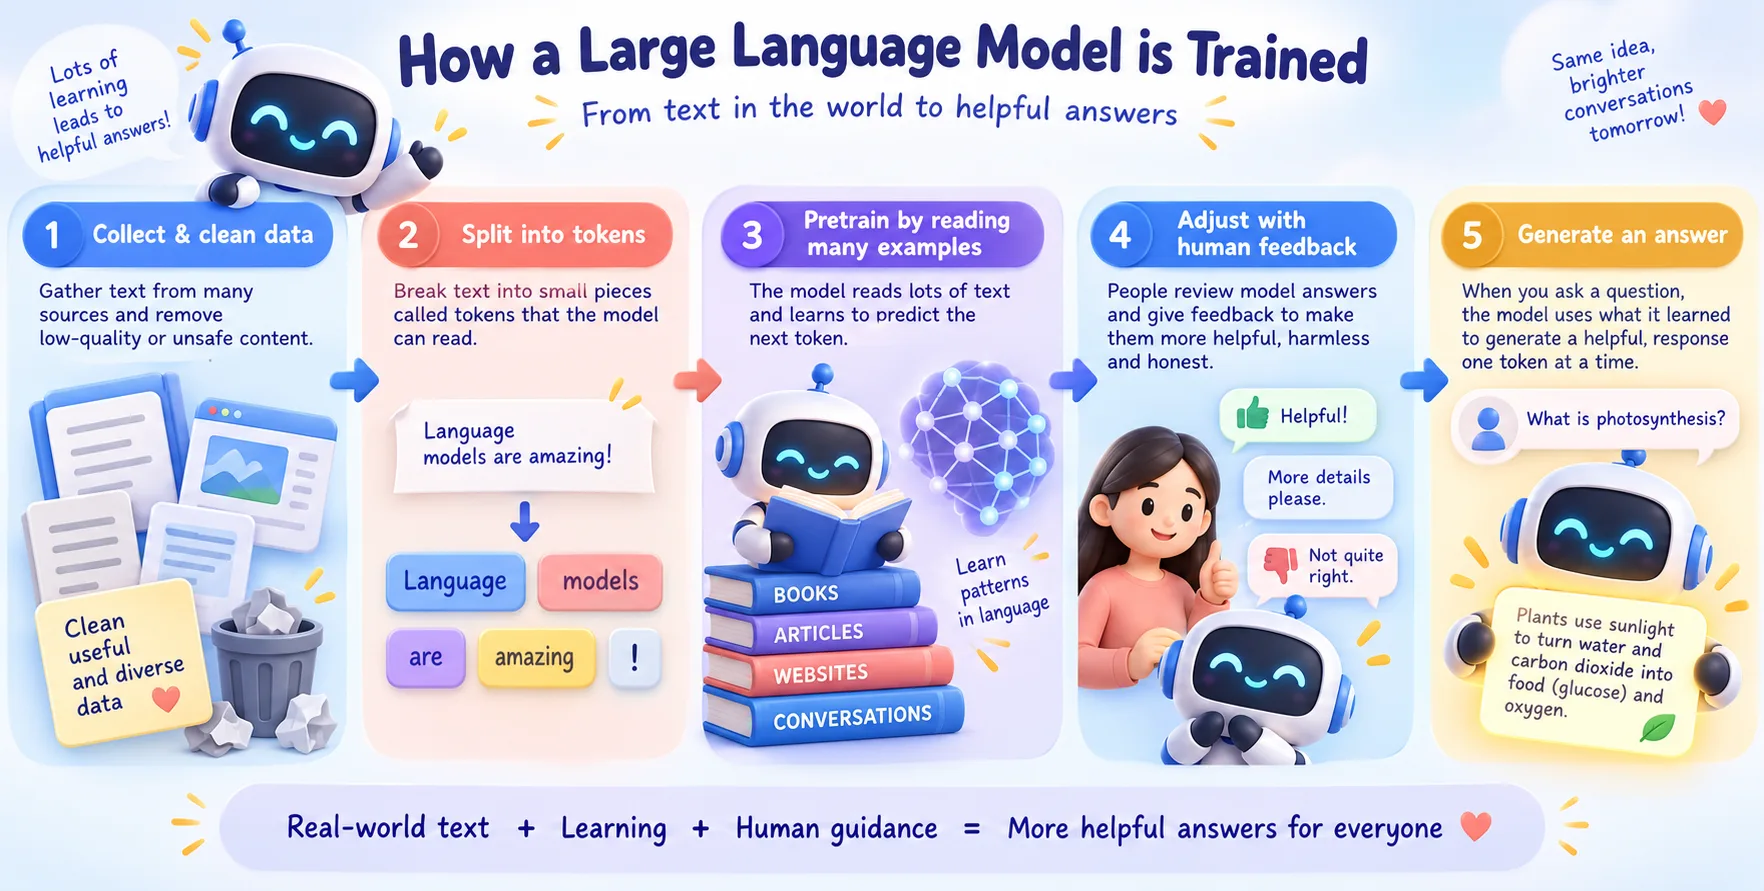
创作一张原创、可爱而清晰的教育信息图,解释大语言模型的训练过程。用一只圆润友善的机器人学习助手和一条色彩协调的视觉流程表示:数据收集与清洗、文本切分为令牌、模型阅读大量示例进行预训练、通过人类反馈进行调整、最后根据用户问题生成回答。每个阶段用简短清晰的中文标签和箭头连接,展示小纸片、令牌积木、神经网络星座、反馈对话气泡和发光回答卡片等视觉隐喻。扁平插画与轻微3D体积感结合,柔和蓝紫、珊瑚和奶油色调,干净浅色背景,层次分明、适合初学者阅读,文字保持少量且排版准确,无真实品牌、无虚构技术参数、无水印。

【English Prompt】
Create an original cute and clear educational infographic explaining how a large language model is trained. Use a friendly rounded robot learning assistant and a coordinated visual pipeline for: collecting and cleaning data, splitting text into tokens, pretraining by reading many examples, adjustment through human feedback, and generating an answer from a user question. Connect each stage with arrows and short accurate English labels, using visual metaphors such as paper snippets, token blocks, a neural-network constellation, feedback dialogue bubbles and a glowing answer card. Combine clean flat illustration with subtle dimensional 3D volume, a soft blue-violet, coral and cream palette, a bright uncluttered background and strong beginner-friendly hierarchy. Keep text sparse and correctly typeset, use no real brands, invented technical numbers or watermark.
可直接复制使用 · [方括号] 处按需替换成你的内容
更多提示词
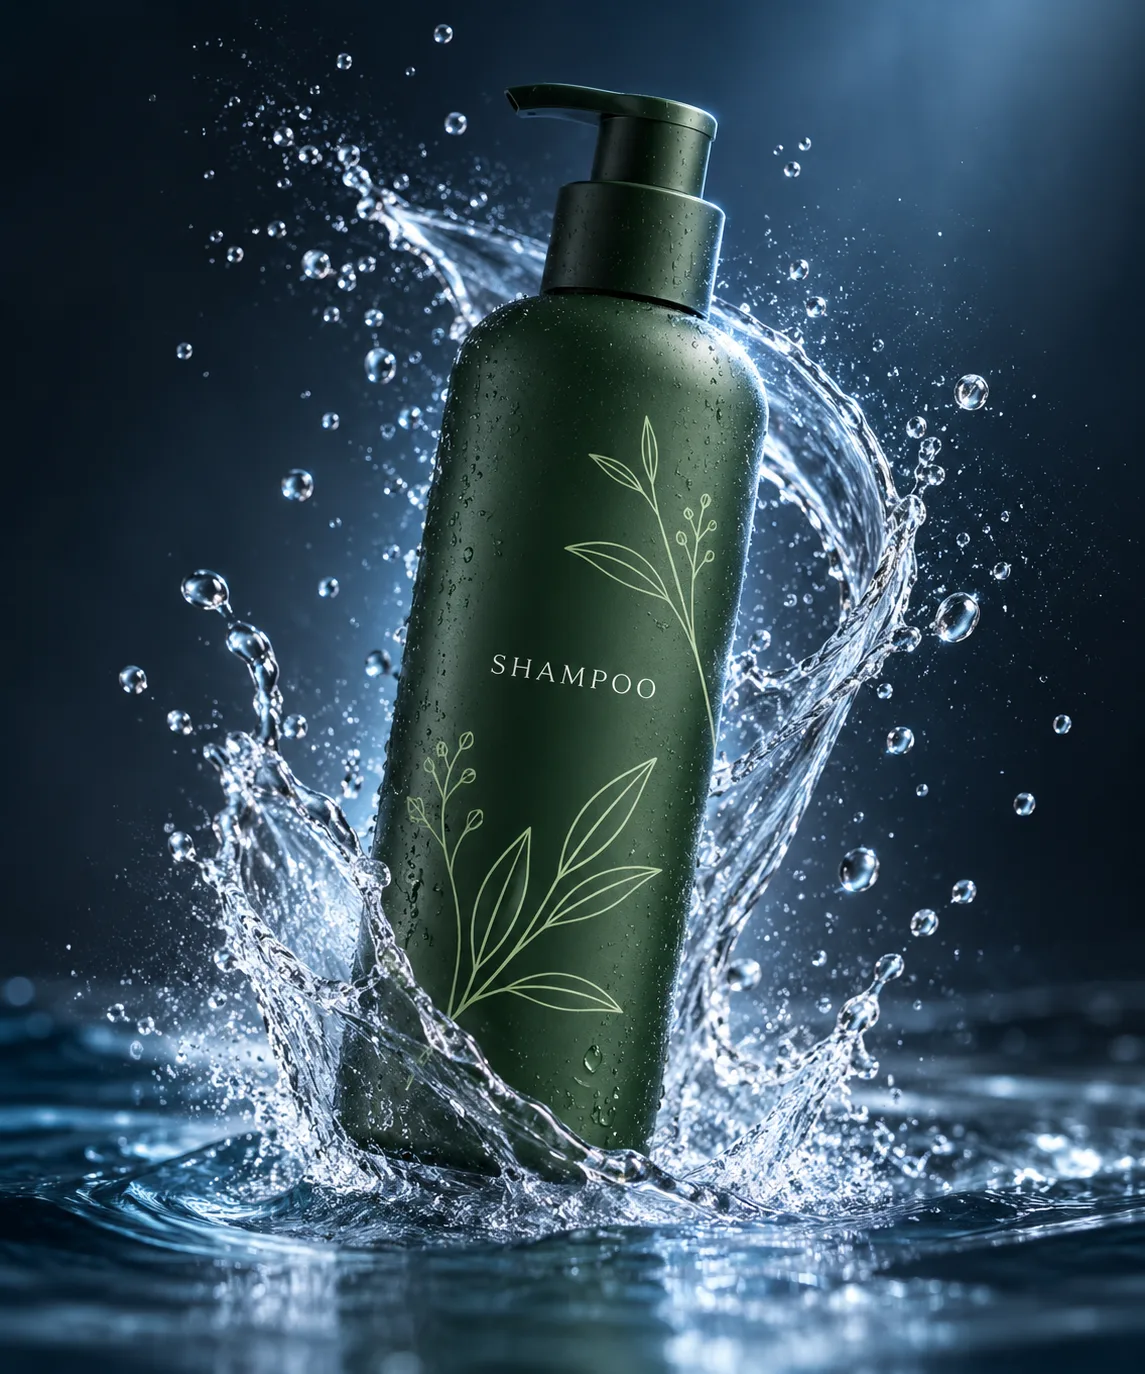
哑光绿瓶的清水飞溅洗发水广告
一只哑光绿色洗发水瓶穿过清澈水花,凝结的水滴与薄雾环绕瓶身;冷蓝影棚光和深色渐变背景营造精致、简洁的个人护理产品广告。 A matte green shampoo bottle moves through a clear-water splash, surrounded by suspended droplets and fine mist; cool blue studio light and a dark gradient create a polished, minimal personal-care product advertisement.
gpt-image-2.5 图像
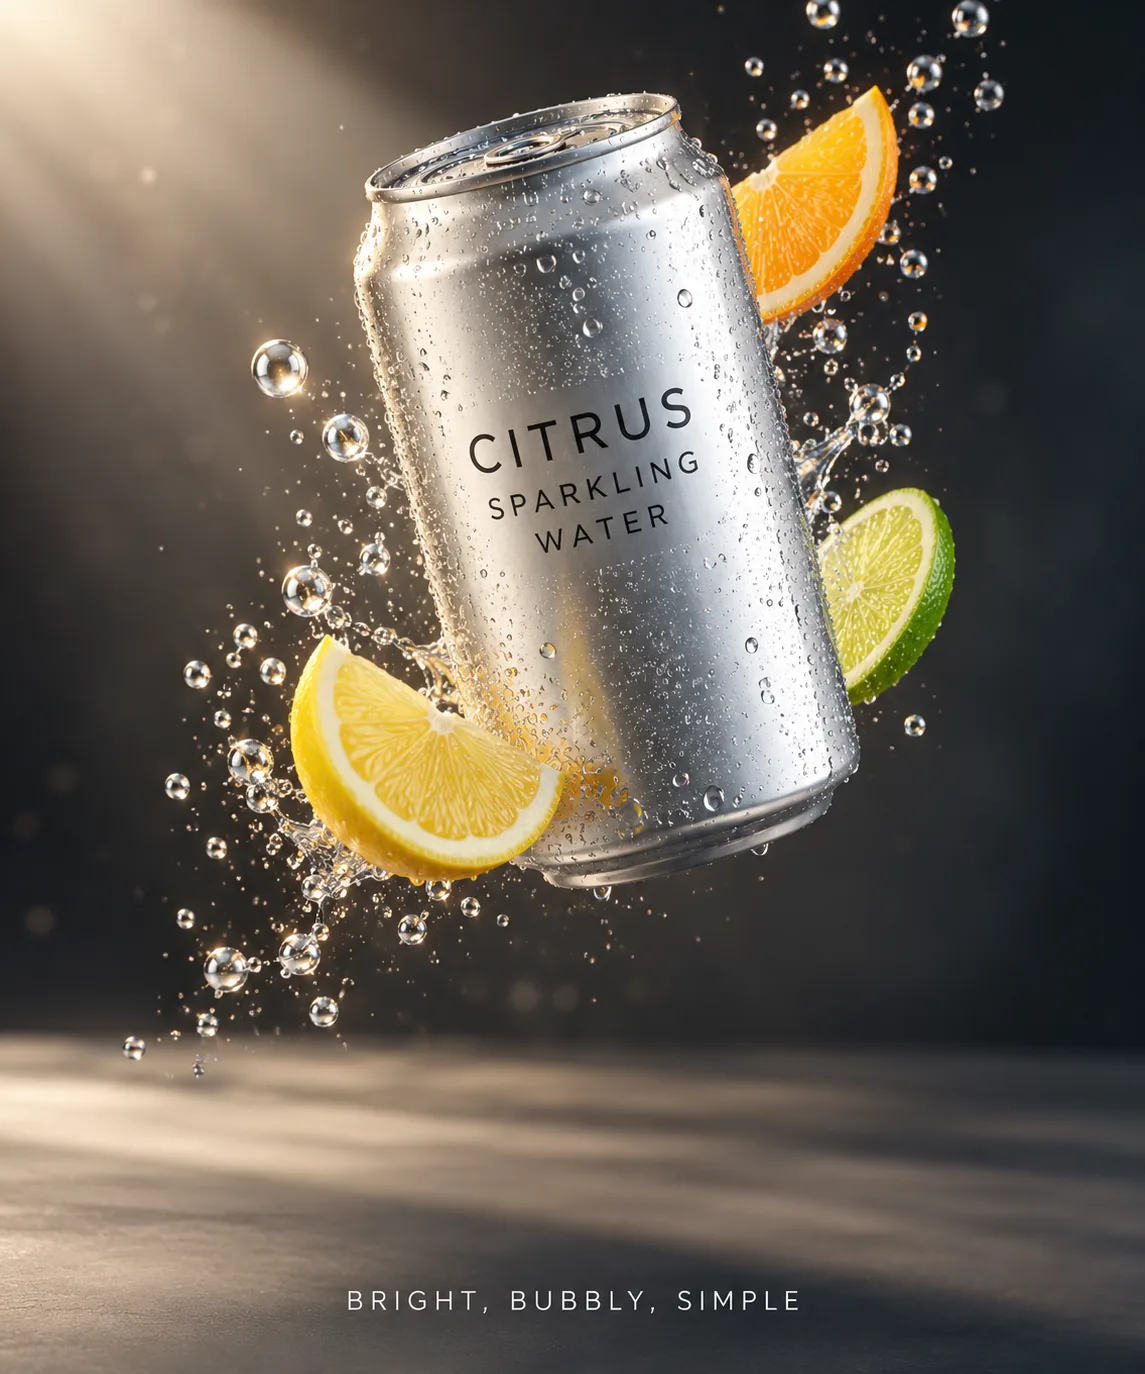
柑橘气泡水的动感3D广告
一罐无品牌柑橘气泡水悬浮在充满动势的影棚场景中,水滴与柑橘片形成克制的粒子轨迹,戏剧性灯光和强对比塑造精致商业广告质感。 An unbranded can of citrus sparkling water floats in a dynamic studio scene, with restrained trails of droplets and citrus slices; dramatic lighting and contrast create a polished commercial-advertising feel.
gpt-image-2.5 图像
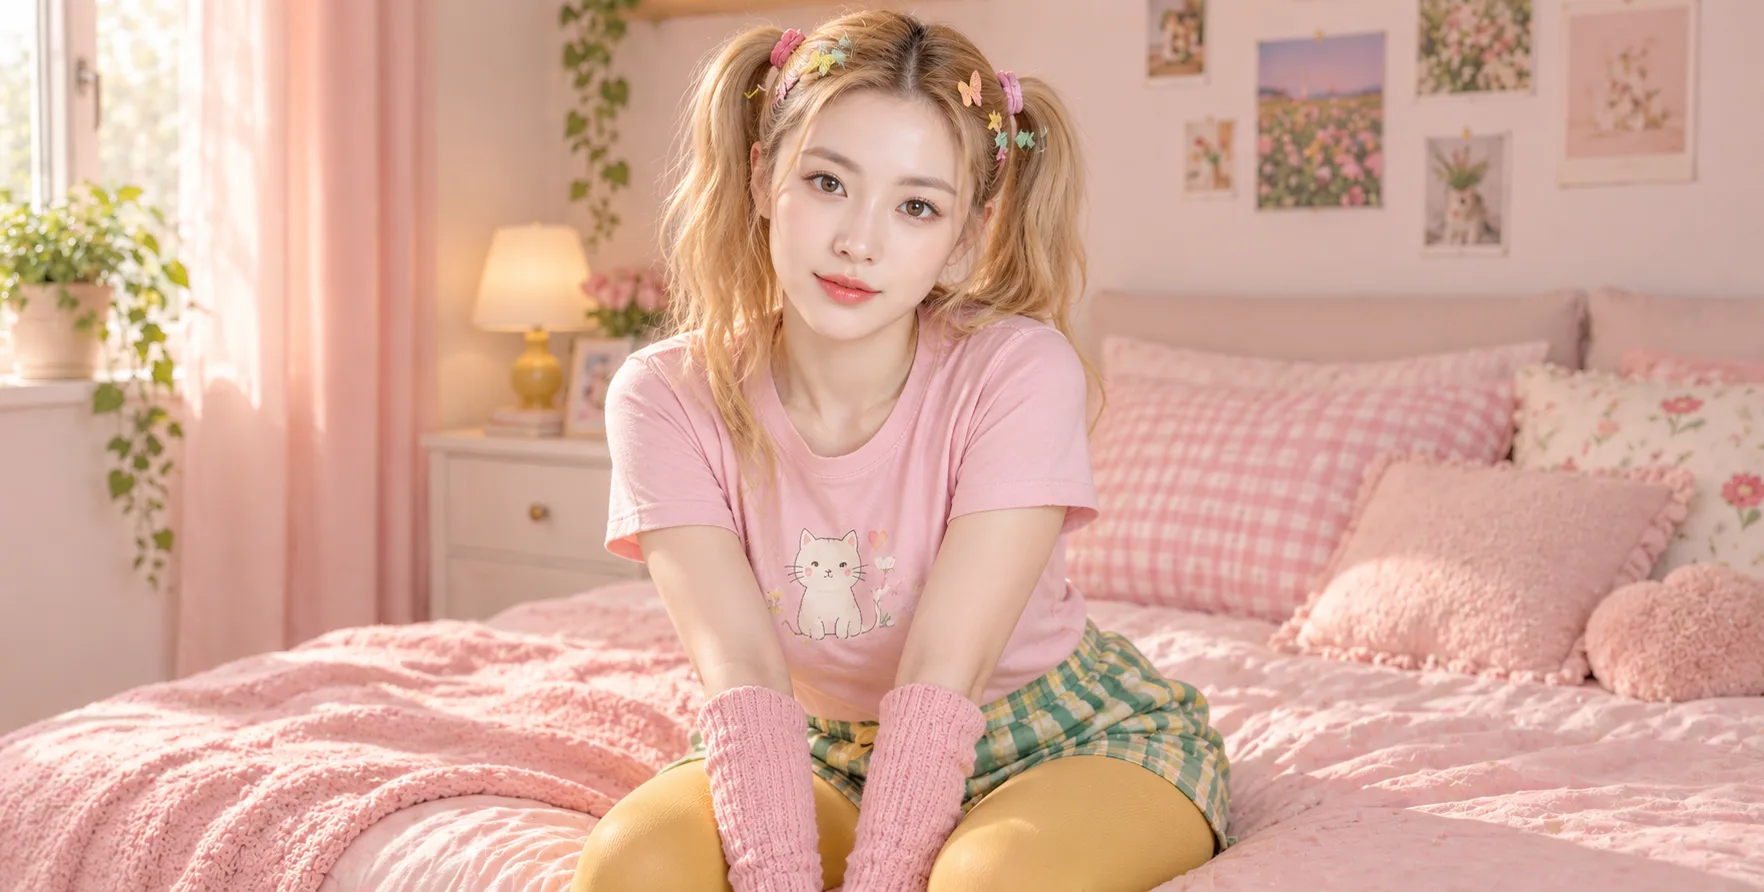
粉彩猫咪主题卧室成人时尚肖像
一位明确成年的时尚女性坐在粉彩卧室的床沿,穿着原创猫咪图案上衣、格纹短裤与保守不透明的打底裤,搭配俏皮发饰。暖和的日光与粉色窗帘营造舒适、轻松的氛围。 A clearly adult fashionable woman sits on the edge of a bed in a pastel bedroom, wearing an original cat-graphic top, plaid shorts, and modest opaque tights with playful hair accessories. Warm daylight and pink curtains create a cozy, relaxed mood.
gpt-image-2.5 图像
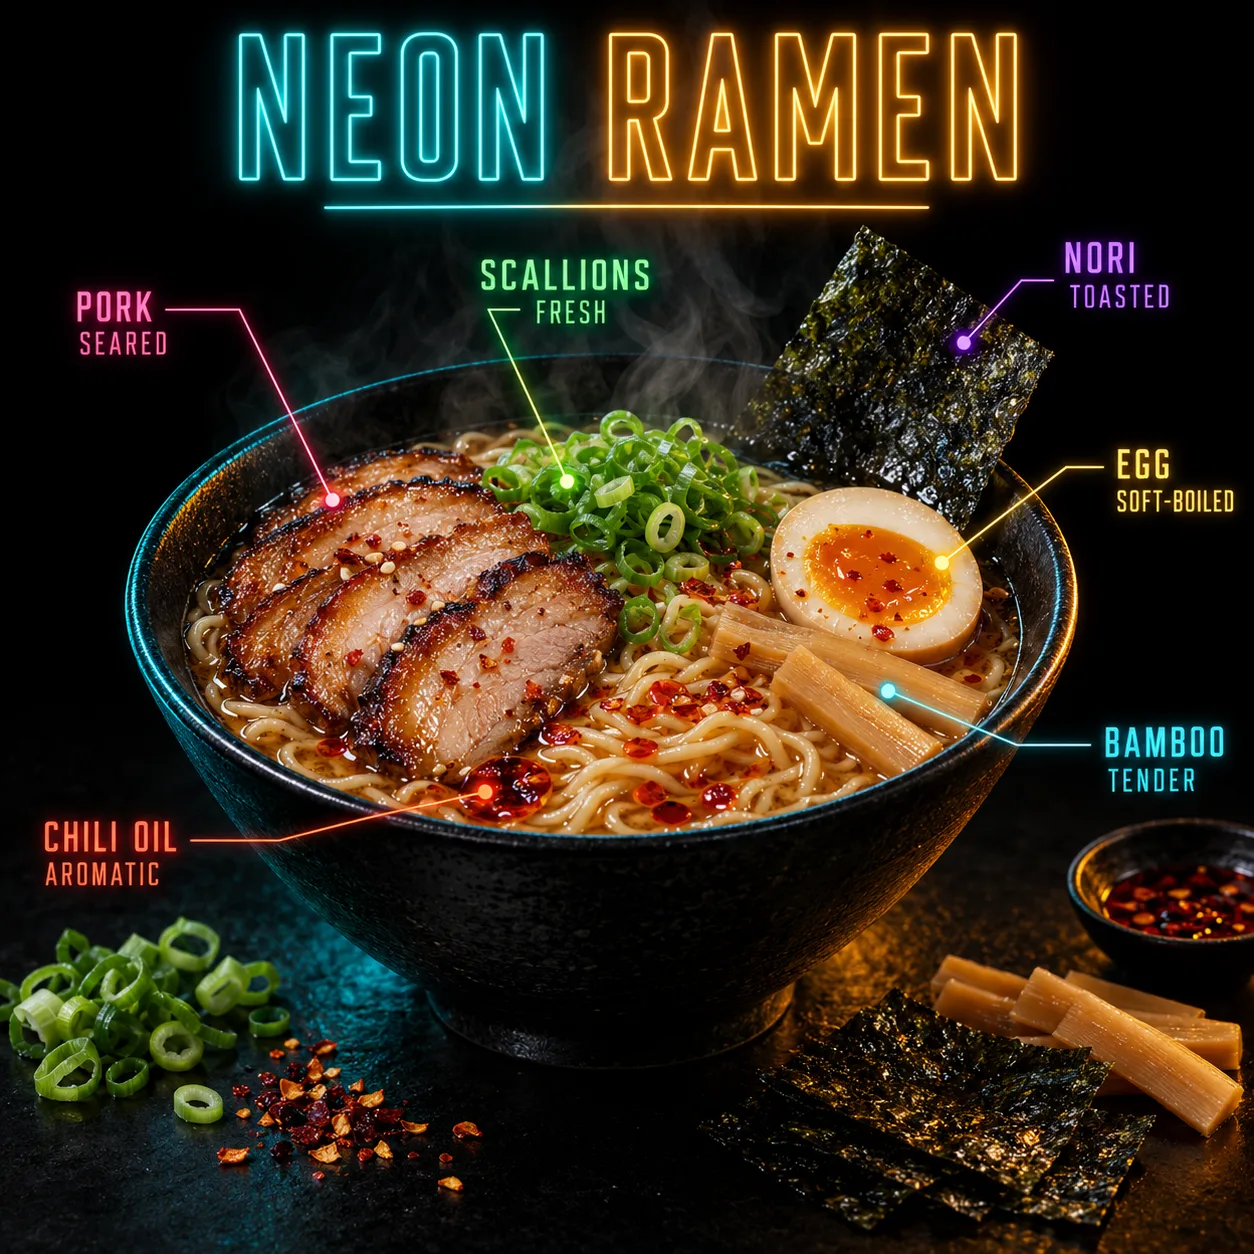
霓虹暗调拉面广告信息图
黑色背景上的戏剧性拉面广告:中央陶碗盛有热气腾腾的拉面,周围点缀少量食材,暖色与电光霓虹边缘光勾勒质感,并以六条清晰引线标签介绍食材。 A dramatic ramen advertisement on black: a central ceramic bowl of steaming noodles, a few supporting ingredients, warm and electric-neon rim light, and six clear leader labels identifying ingredients.
gpt-image-2.5 图像
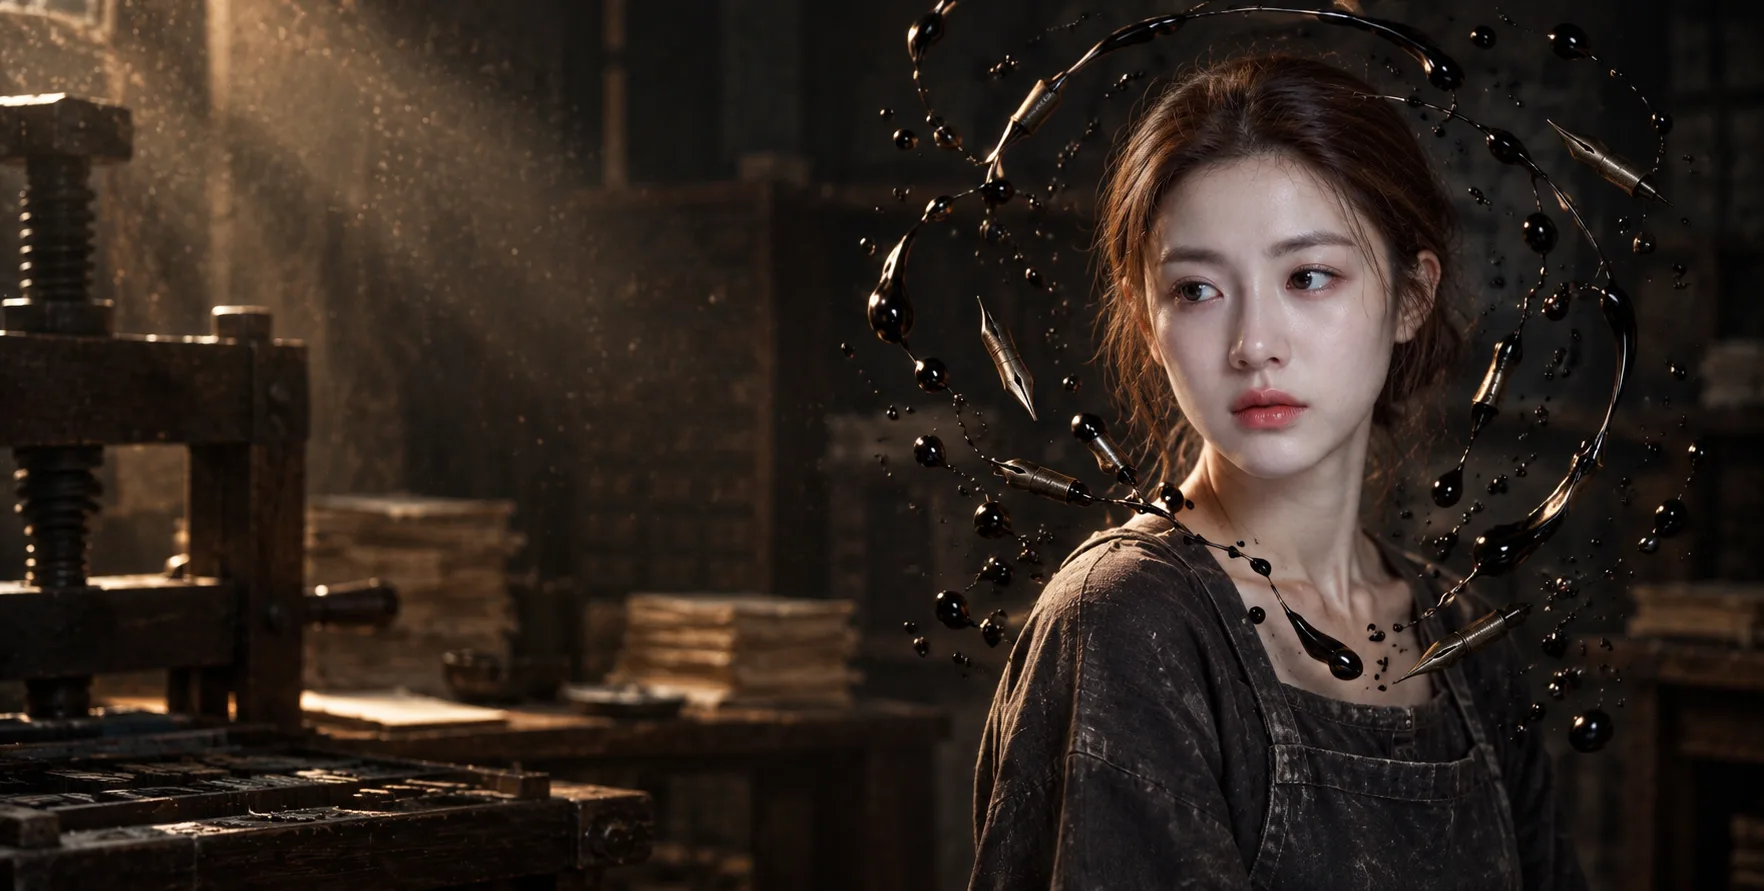
古董印刷作坊中的墨色超现实忧郁肖像
一位成年女性在昏暗多尘的古董凸版印刷作坊中沉思,位于宽幅画面的最右侧,左侧留有大片负空间。抽象黑墨水珠与古董金属字模笔尖在她周围形成密集而有机的悬浮轨迹,但不接触皮肤;暖色光束穿过尘埃,照亮墨水光泽与亚麻工作罩衫。 An adult woman sits pensively in a dim, dusty antique letterpress workshop, positioned at the far right of a wide frame with generous negative space on the left. Abstract black-ink droplets and antique metal nibs form a dense organic suspended pattern around her without touching her skin; a warm shaft of light through dust reveals glossy ink and a linen work smock.
gpt-image-2.5 图像
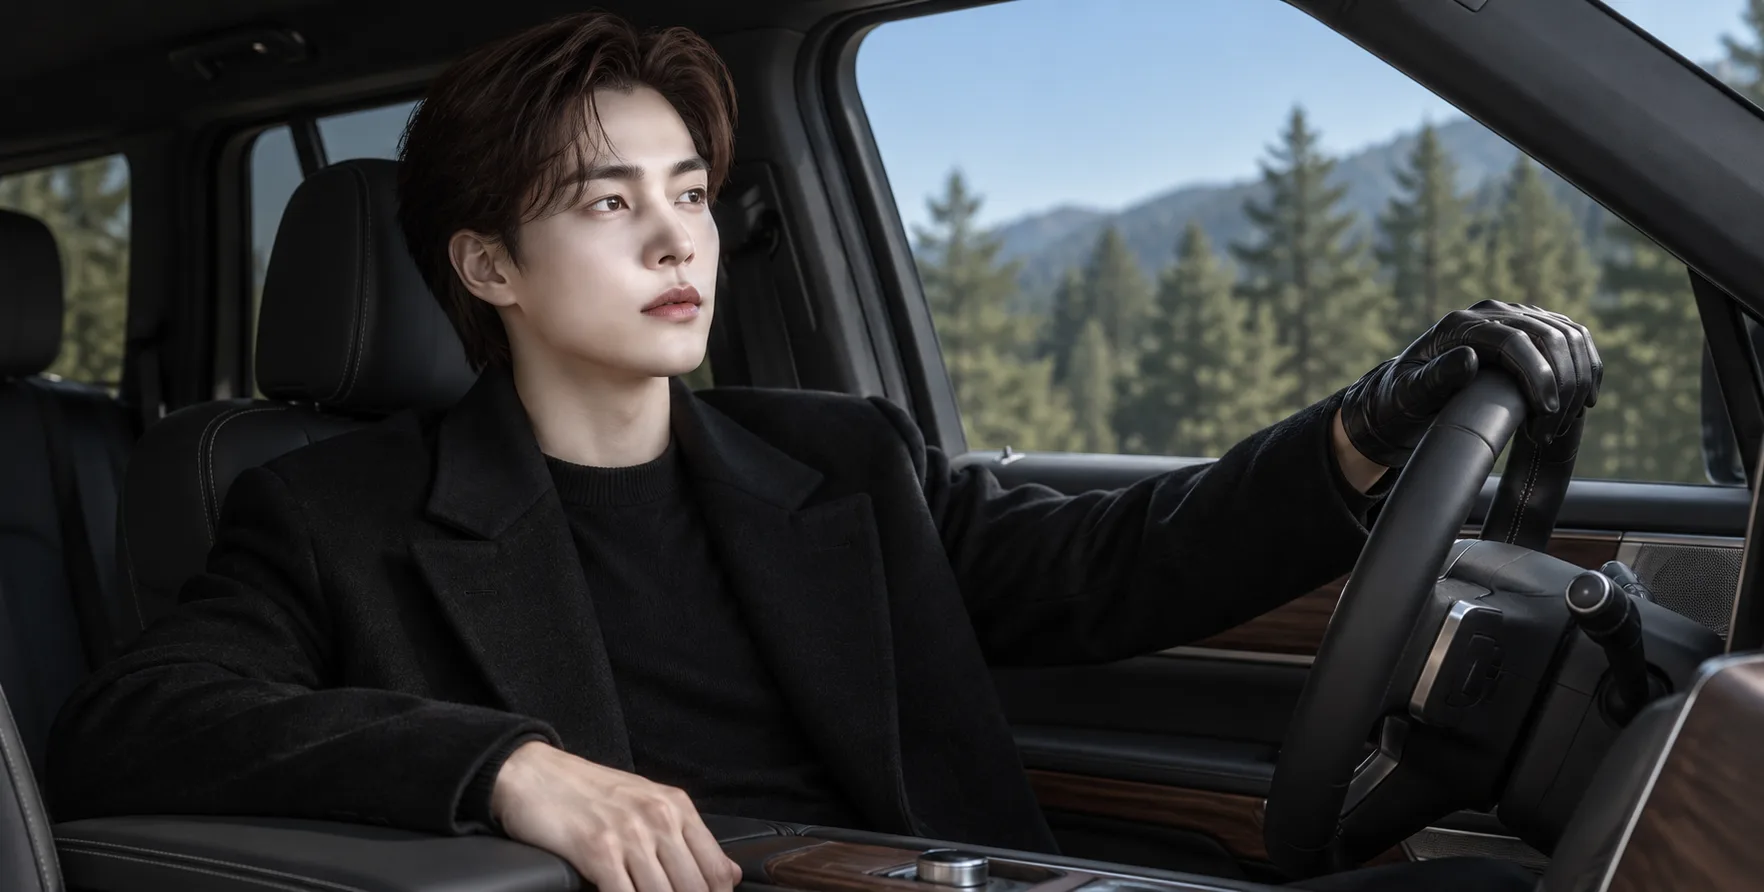
豪华风格SUV内的成年绅士编辑人像
一位成年男性身穿黑色大衣与皮手套,安静地坐在停放中的高端SUV驾驶座,左手轻搭方向盘,目光自信地望向窗外上方。柔和窗光照亮面部,松绿色景观与天蓝色天空映入车窗,黑色内饰和暖棕木饰条营造克制奢华感。 An adult man in a black coat and leather gloves sits calmly in the driver's seat of a parked premium SUV, one hand resting lightly on the wheel and his confident gaze directed upward out the window. Soft window light illuminates his face; pine-green scenery and blue sky appear outside, with understated dark upholstery and warm wood trim.
gpt-image-2.5 图像